不用录音频样本,几句描述就能捏出专属音色
不用录音频样本,几句描述就能捏出专属音色
青萍叙事前言
前阵子给视频配解说,想要一个低沉浑厚、慢条斯理的男声。
音色列表翻了个遍,挨个试听,最接近的也总差一口气。
青萍语音里有个音色设计功能,思路完全反过来。
不挑现成的,而是把想要的声音写成一段描述,让模型现场捏一个。
试了几轮发现,捏音色难点不在工具,在描述。
描述写准了,一两句就能捏出八九不离十的声音,写得糊,生成十次都不对味。
不录音也能捏
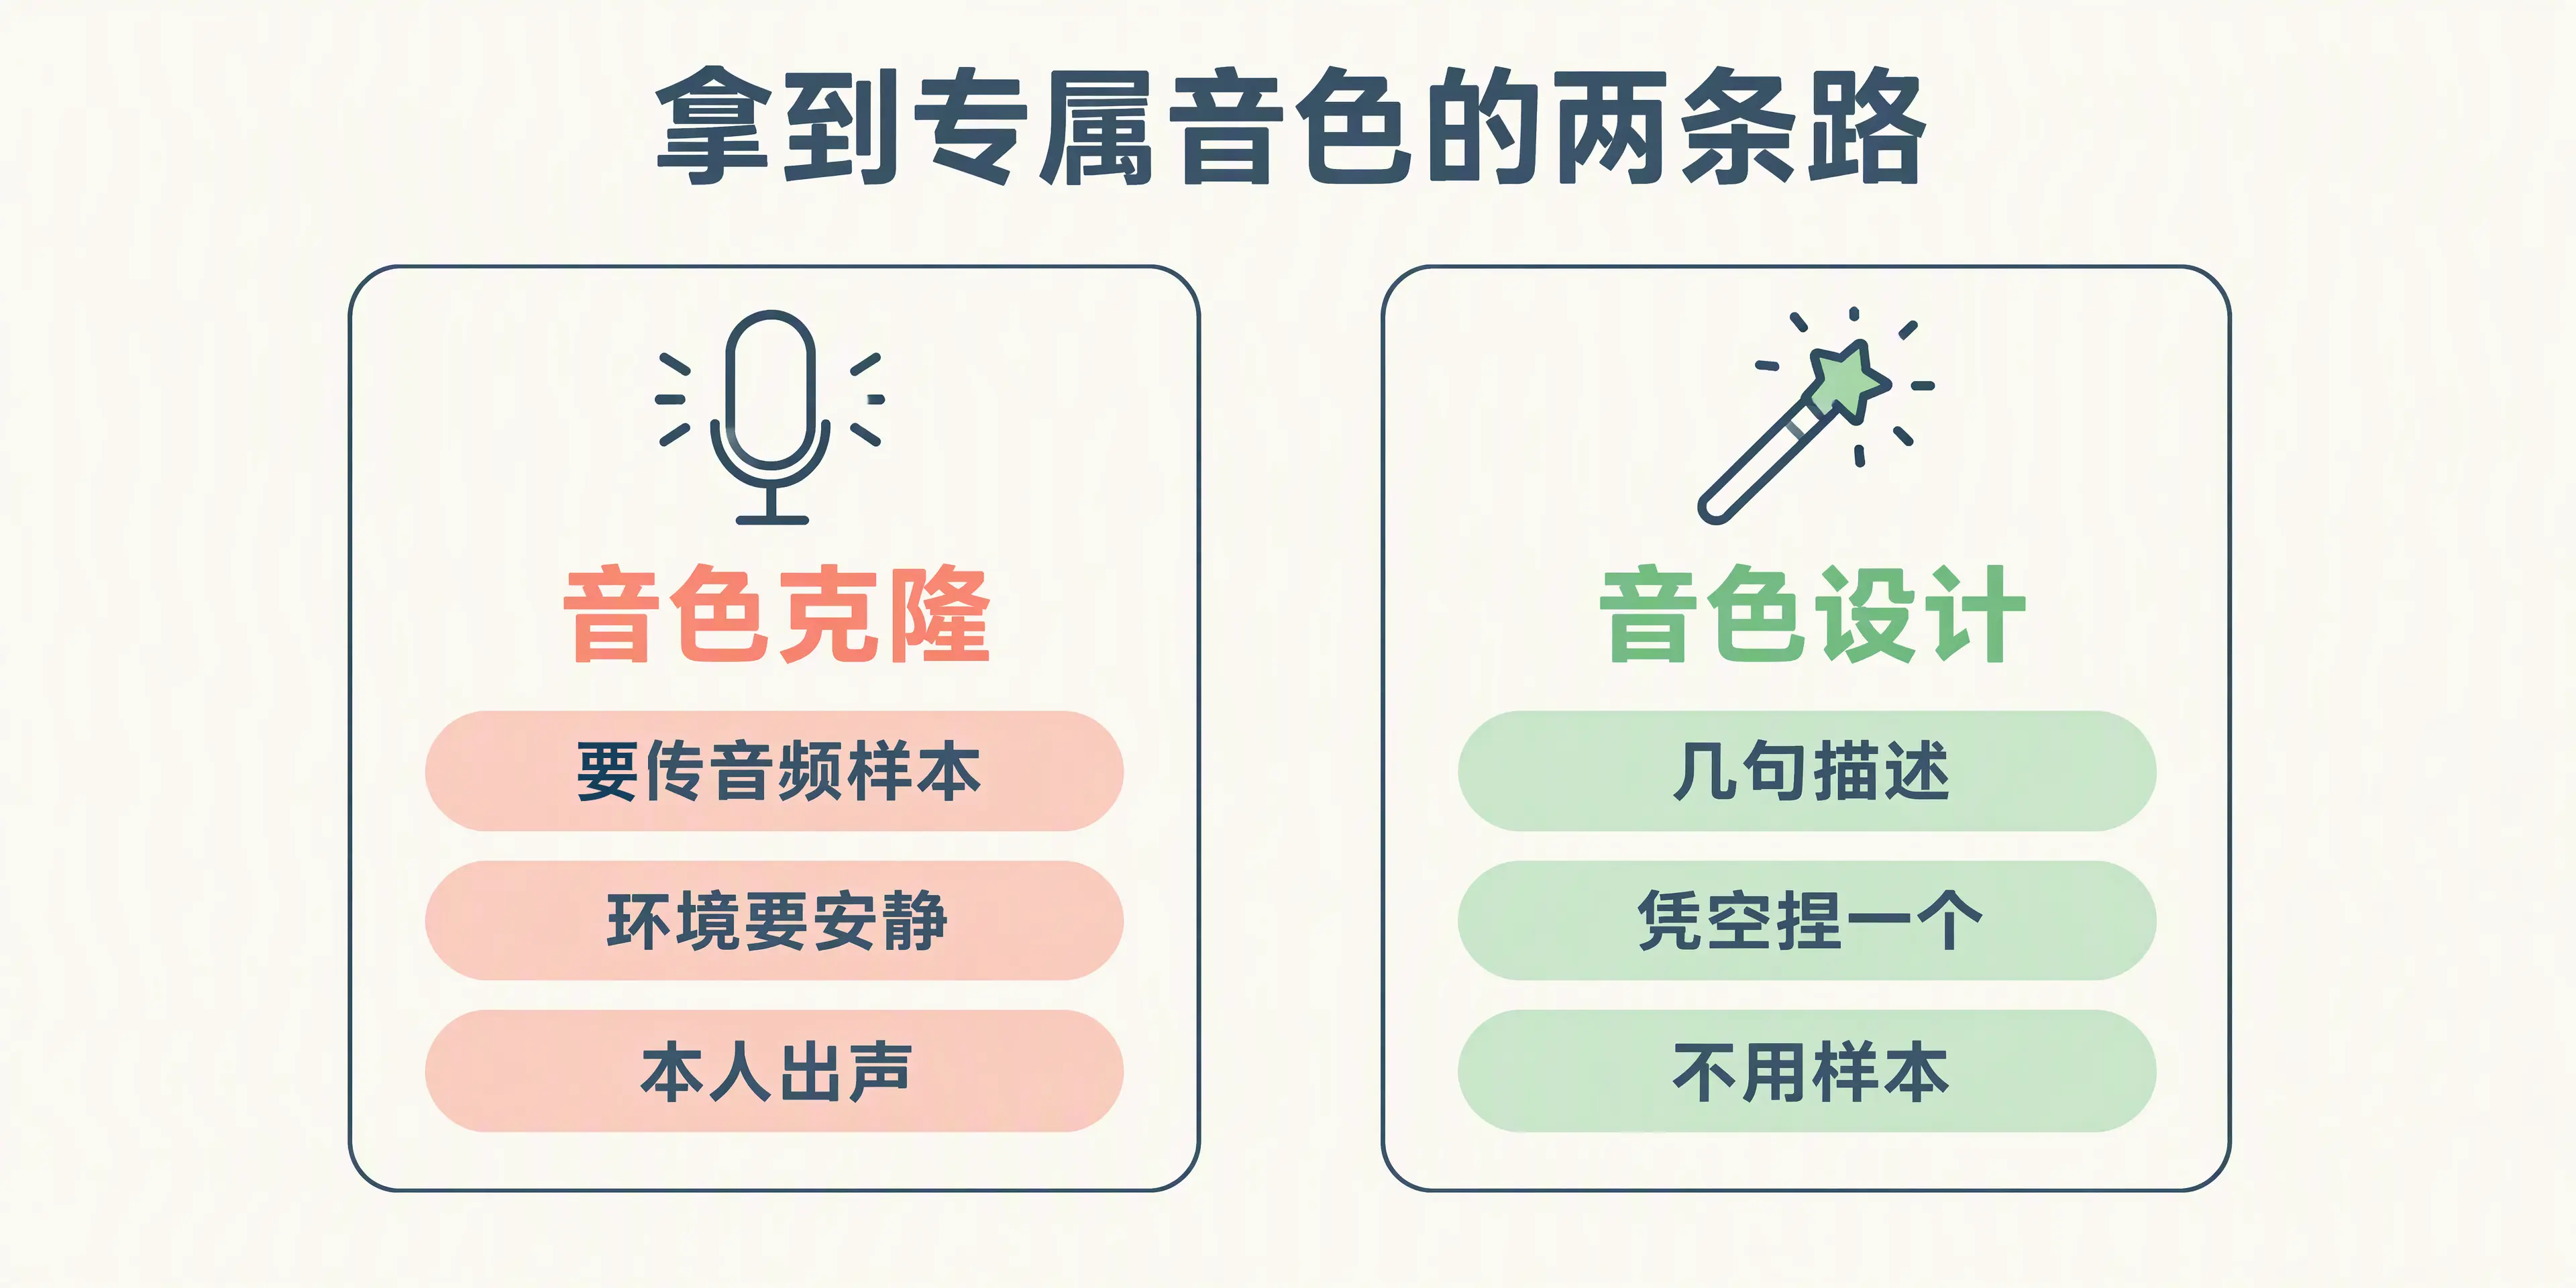
拿到专属音色,一般有两条路。
一条是音色克隆,传一段音频样本,让模型照着还原声音。
门槛在录音,环境要安静,还得本人出声。
另一条是音色设计,一条样本都不用,写几句描述,凭空捏一个。
青萍语音里两条路都有,手头没样本时,音色设计更合适。
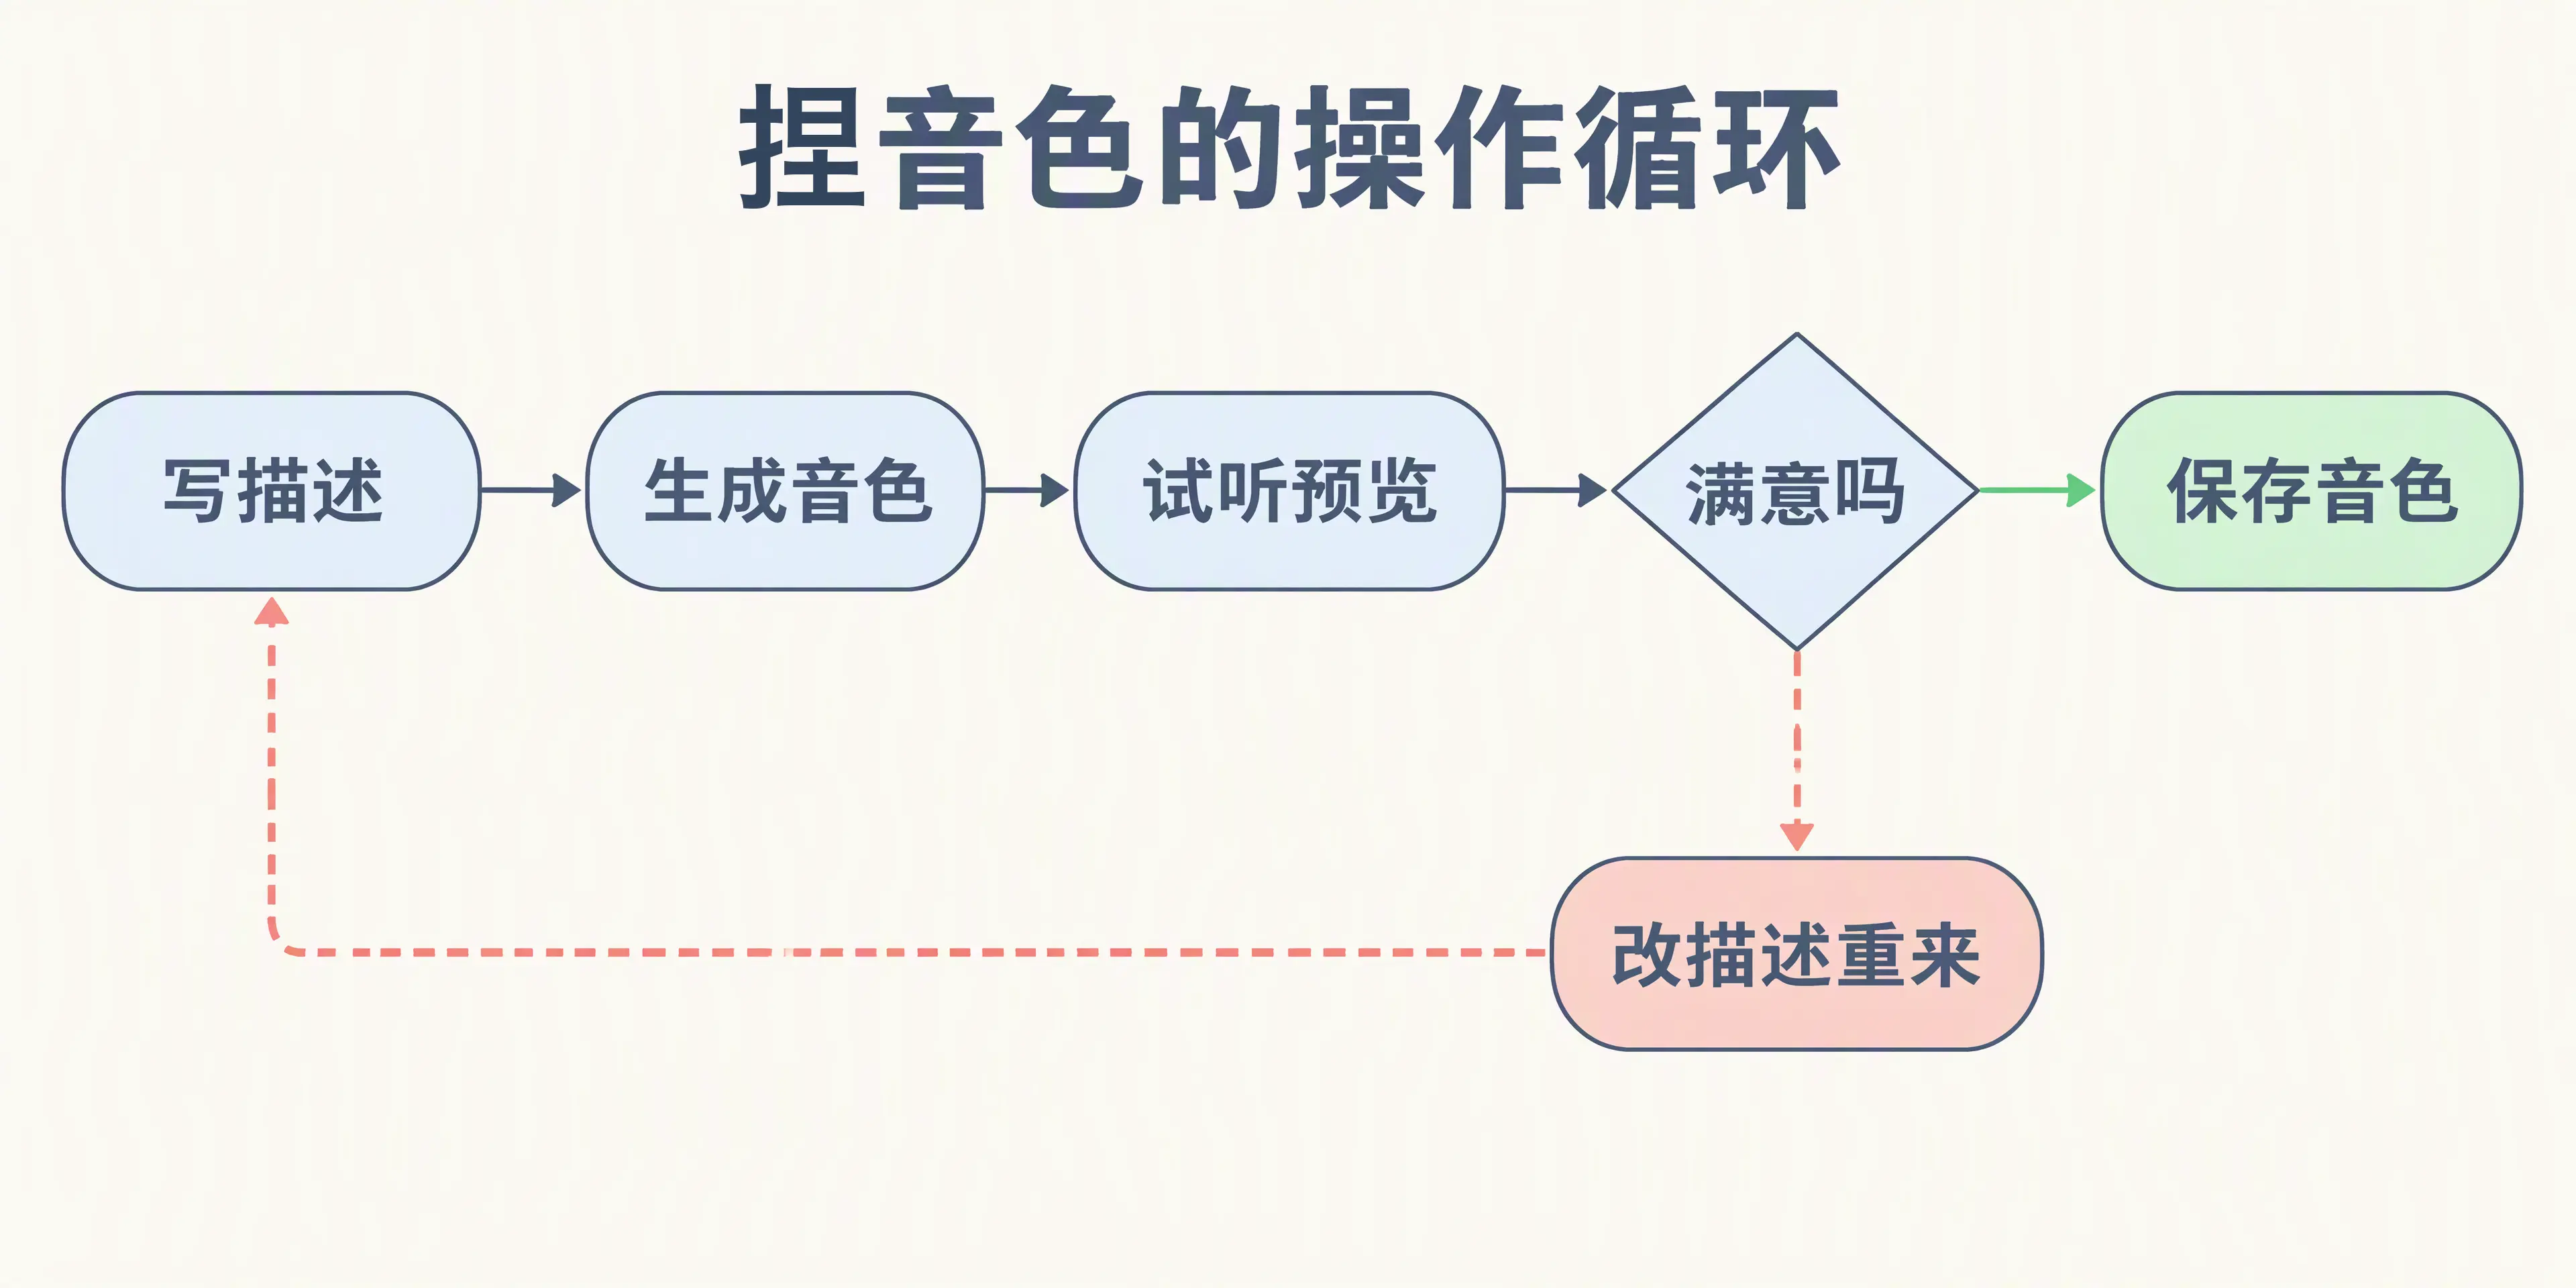
流程很简单,交一段描述和一段试听文本,平台生成音色,附一段预览音频。
满意就留着直接配音,不满意就改描述重来。
描述的五个原则
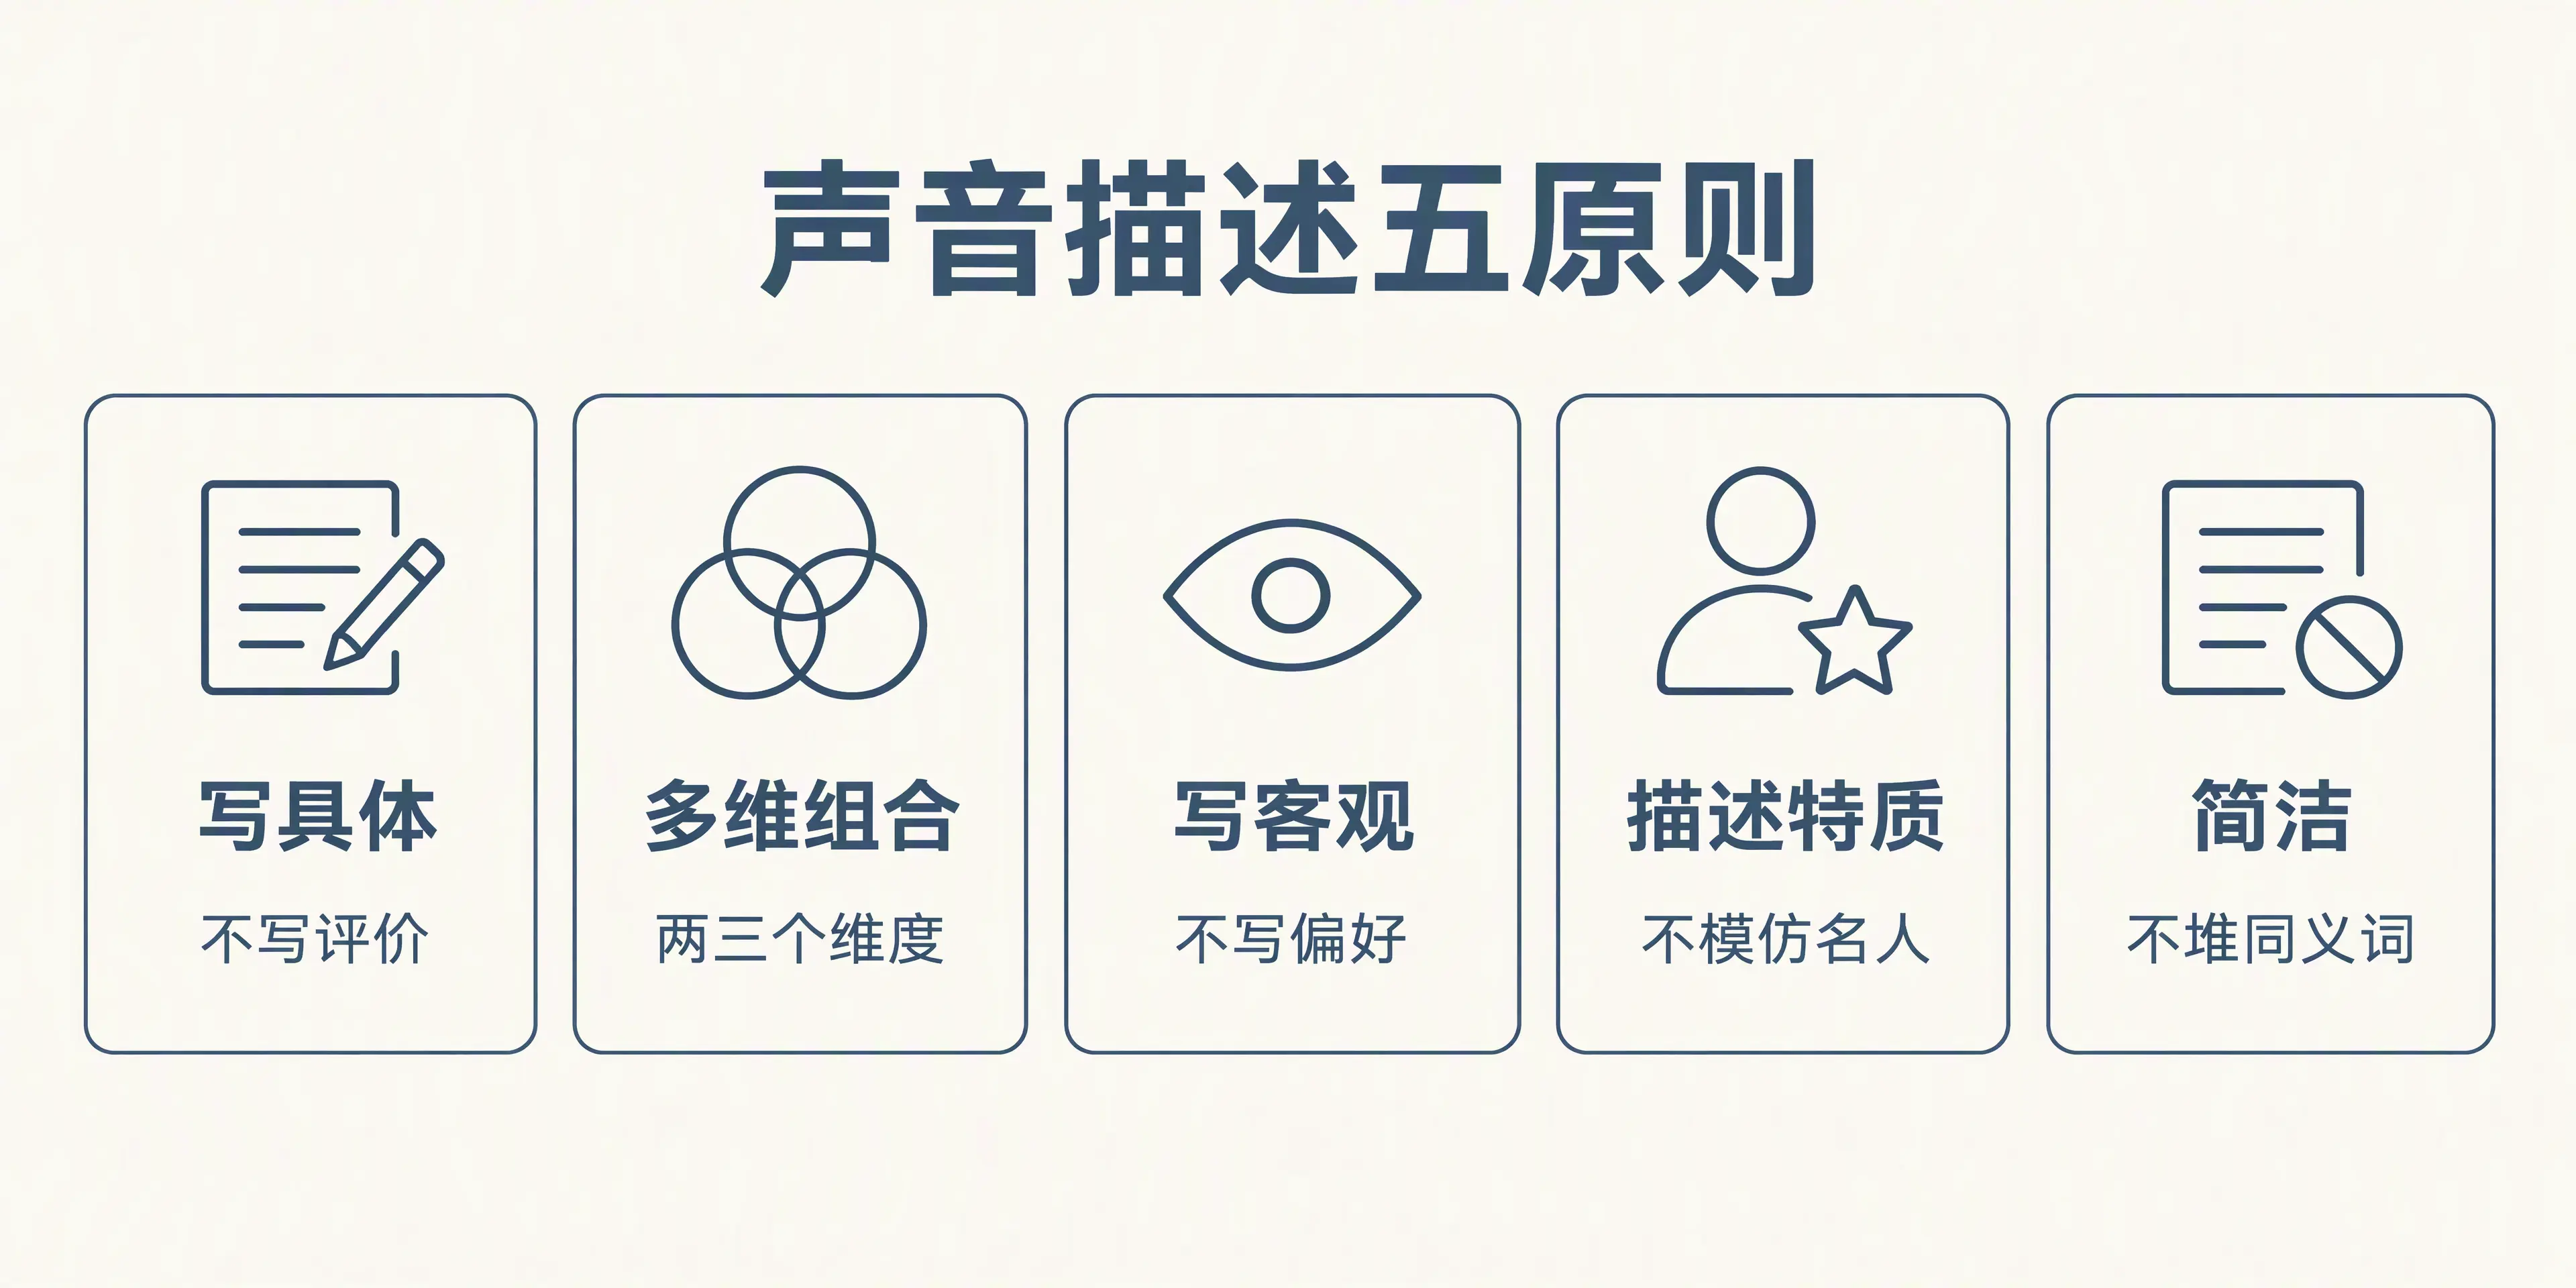
琢磨下来,描述的写法有五条原则。
写具体,不写评价。
低沉、清脆、语速偏快是声音特征,好听、普通、高级是模糊评价。
模型认特征,不认评价。
多维组合,别单打独斗。
只写女声等于什么都没写,天底下的女声千差万别。
性别、年龄、语速、情感,至少凑上两三个维度,声音的轮廓才立得住。
写客观特征,不写主观偏好。
音调偏高、充满活力是听得出来的特征,我最喜欢的声音这种话,模型无从下手。
描述特质,不点名模仿。
想要磁性就写有磁性,照着明星捏,模型不支持,还可能踩版权的坑。
简洁,别堆同义词。
沉稳、低沉、浑厚堆一串,信息量没增加,反而稀释重点。
七个维度搭积木
原则定完,我把能填的维度挨个拆了一遍。
性别,男性、女性、中性。
年龄,儿童、青少年、青年、中年、老年,儿童指五到十二岁,青年指十九到三十五岁。
音调,高音、中音、低音,或偏高、偏低。
语速,快速、中速、缓慢,也能写偏快、偏慢。
情感,开朗、沉稳、温柔、严肃、活泼、冷静、治愈。
特点,有磁性、清脆、沙哑、圆润、甜美、浑厚、有力。
用途,新闻播报、广告配音、有声书、动画角色、语音助手、纪录片解说。
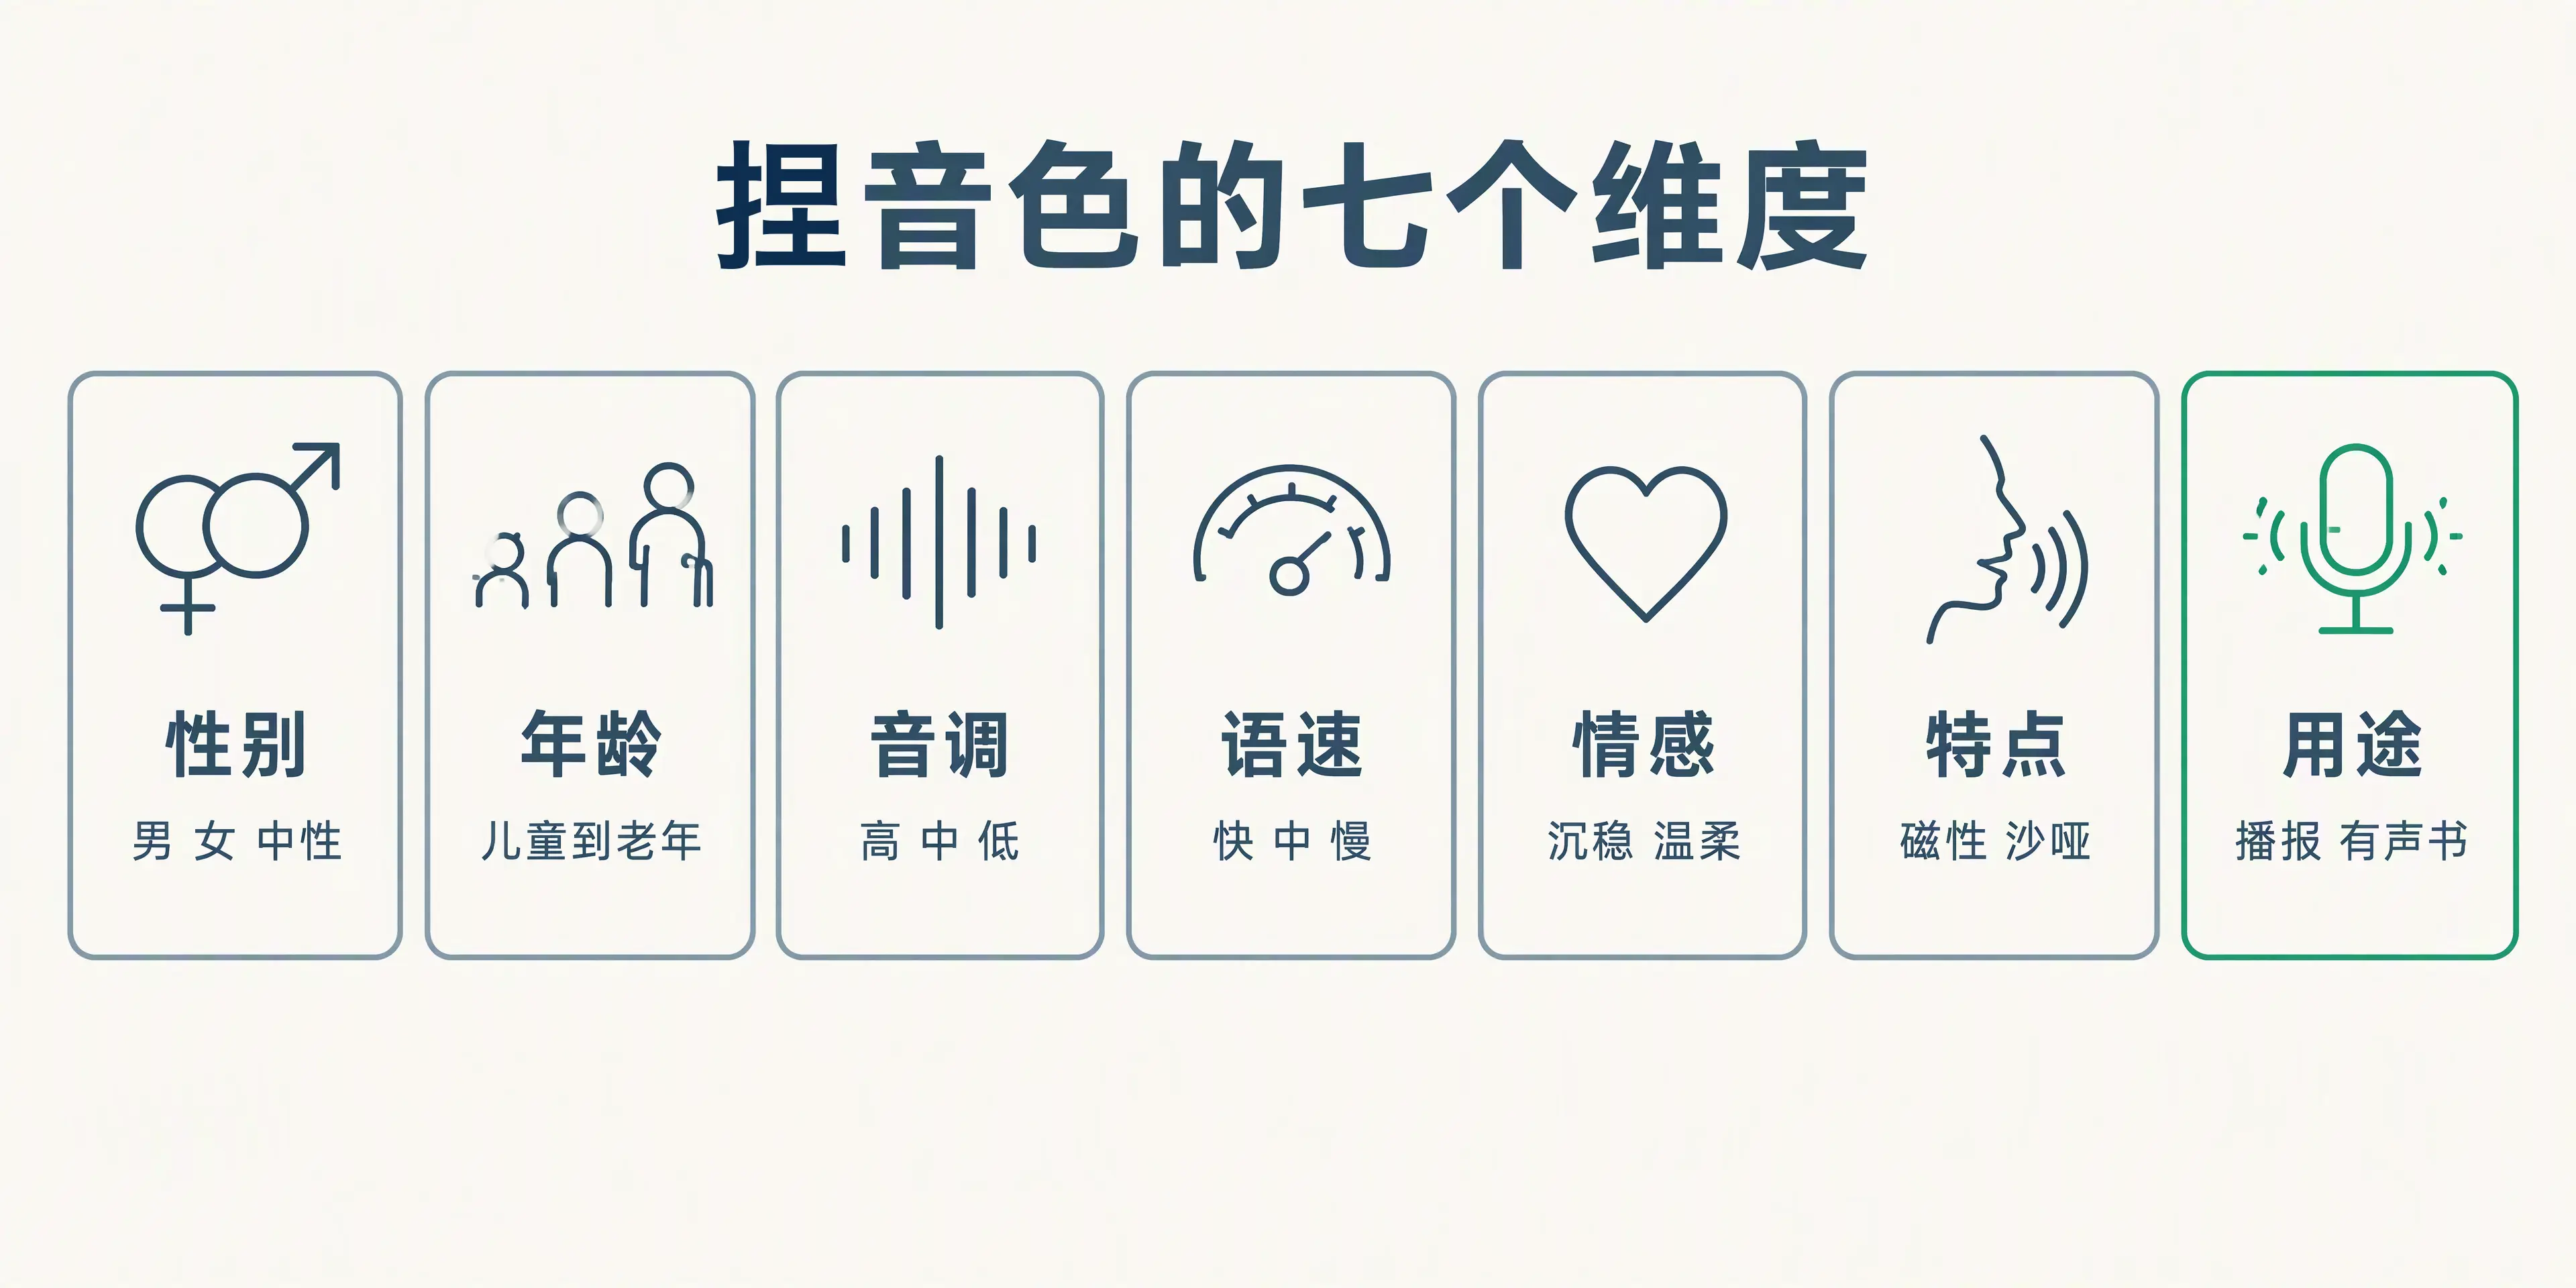
前六个维度拼出声音本身,最后一个用途维度最有意思,它帮模型对齐场景。
同样是沉稳,新闻播报的沉稳和睡前故事的沉稳,出来是两种声音。
几条例句里,我最推荐这一句的写法。
温柔知性的女性,30 岁左右,语调平和,适合有声书朗读。
拆开看,性别加年龄定身份,语调平和定节奏,用途定场景,一句话里每个词都在干活。
动手捏一个试试
我拿温柔知性的有声书女声练了练手。
第一版写的是温柔知性的女声,音色能用,但偏年轻,少了点书卷气。
第二版补上年龄锚点和用途,改成 30 岁左右、语调平和、适合有声书朗读,声音一下就稳下来了。
有个特性要留意,相同的描述,每次生成的音色并不一样。
所以创建完先听预览,同一描述多生成几次,挑最接近的留下。
试听文本也有讲究,别用示例里那种万能句子,直接放你真实要配的文案。
解说是解说腔,广告是广告腔,用真实内容试出来的音色才作数。
描述不用长,两三个维度加一个用途,一句话足够。
从挑变成捏
现在开新视频,我不再翻音色列表,先把想要的声音写出来。
维度凑不齐就先捏一版,听了再加,多数两三轮就到位。
实在想要真人质感,平台里还有大量专业配音员,纪录片、广告、有声书各有擅长,先试音再下单。
微信搜索 青萍语音 小程序就能体验。